L'expression « faire tourner sa propre petite amie IA » laisse croire à un seul programme. En pratique, ce sont trois pièces qui dialoguent entre elles, et comprendre le rôle de chacune évite l'essentiel des frustrations.
Les trois pièces
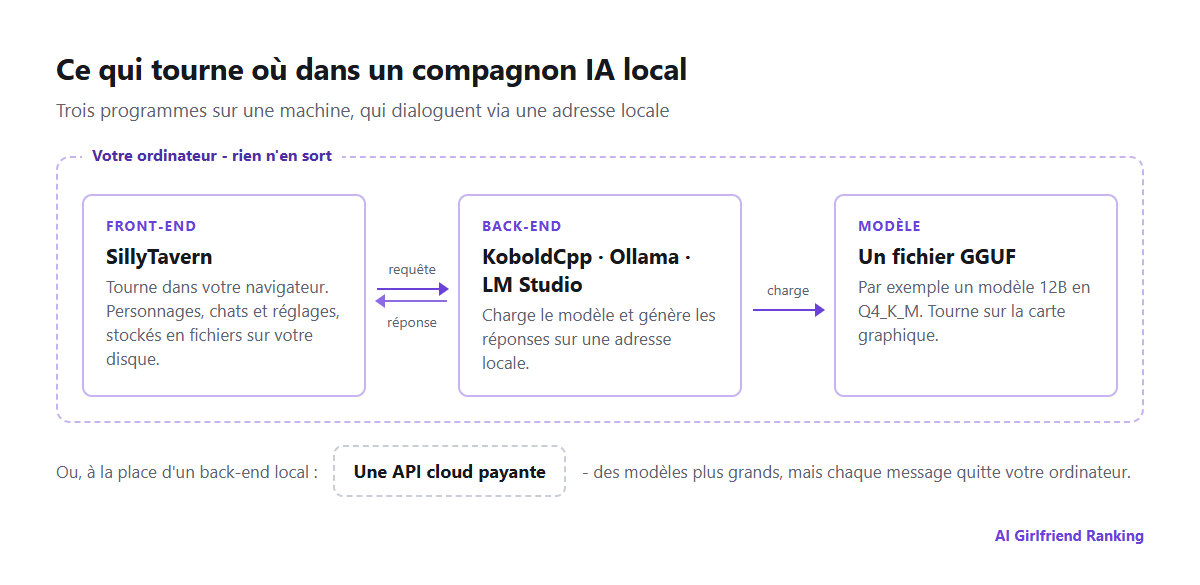
Qui parle à qui dans une installation locale typique.
Le front-end est ce que vous voyez : fenêtres de discussion, personnages, avatars, réglages. SillyTavern est le choix de référence pour le chat avec personnages. Il s'exécute dans votre navigateur, stocke personnages et conversations sous forme de fichiers sur votre disque, et se connecte à presque n'importe quel back-end. Il ne génère pas de texte lui-même.
Le back-end charge le modèle et génère les réponses. KoboldCpp est un programme unique, sans installation, apprécié pour le jeu de rôle parce qu'il expose tous les paramètres de génération. Ollama est le moyen le plus simple de lancer un modèle en quelques commandes. LM Studio est une application de bureau dotée d'un catalogue de modèles agréable à parcourir. N'importe lequel d'entre eux met le modèle à disposition sur une adresse locale à laquelle se connecte le front-end.
Le modèle est un gros fichier, en général au format GGUF, téléchargé sur Hugging Face. Sa taille en paramètres - 8B, 12B, 24B - et sa quantification déterminent sa qualité et le matériel dont il a besoin.
La question du matériel
Ce qui décide si un modèle tourne bien, c'est la mémoire graphique (VRAM). Le modèle doit y tenir, avec de la place pour la conversation elle-même. La quantification réduit les modèles pour les faire entrer : « Q4_K_M » est le compromis courant entre taille et qualité.
| Taille du modèle | Mémoire approx. en Q4 | Matériel typique | À quoi s'attendre |
|---|---|---|---|
| 7-8B | 5-6 Go | Carte graphique de 8 Go | Cohérent, rapide, oublie les détails dans les longues scènes |
| 12-14B | 9-10 Go | Carte de 12 Go | Personnages et prose nettement meilleurs |
| 22-24B | 14-16 Go | Carte de 16-24 Go | Proche des bonnes applications hébergées pour le jeu de rôle |
| 70B | 40 Go et plus | Deux cartes ou un Mac à forte mémoire | Excellent, lent et coûteux |
Ces chiffres sont approximatifs : un contexte plus long demande de la mémoire en plus. Les Mac Apple Silicon partagent la mémoire entre processeur et graphique, si bien qu'un MacBook de 32 Go peut faire tourner des modèles qu'une carte graphique de 12 Go ne peut pas. Un modèle qui ne tient pas déborde sur le processeur principal et ralentit jusqu'à l'agonie - si les réponses arrivent à quelques mots par seconde, passez à un modèle plus petit avant d'essayer une quantification plus brutale. Un modèle plus petit en bonne qualité vaut généralement mieux qu'un plus gros trop compressé.
Ce que vous gagnez
- Une confidentialité qui ne dépend pas d'une politique. Rien ne quitte la machine. Pas de durée de conservation, pas d'entraînement, pas d'accès du personnel, rien à supprimer plus tard.
- Aucun filtre au-delà de celui du modèle. Vous choisissez le modèle, y compris ceux réglés spécialement pour le jeu de rôle. Le plancher légal sur les contenus s'applique toujours à vous, mais aucun opérateur n'ajoute de règles par-dessus.
- Ni abonnement ni crédits. Générez autant que vous voulez.
- Des personnages qui vous appartiennent. Les fiches de personnage sont de simples images PNG qui contiennent la fiche du personnage. Elles passent d'un front-end à l'autre et aucune mise à jour ne peut vous les retirer.
- La stabilité. Un modèle qui fonctionne aujourd'hui fonctionnera de la même façon dans cinq ans. Personne ne peut le remplacer sous vos pieds - le risque décrit dans quand votre compagnon IA change du jour au lendemain.
Ce à quoi vous renoncez
- Le temps d'installation. Comptez une soirée pour la première conversation qui marche, et des semaines de bricolage si cela vous plaît.
- La mémoire devient votre affaire. Les applications hébergées résument et stockent discrètement des faits sur vous. En local, vous gérez cela avec les lorebooks, les résumés et les notes de personnage de SillyTavern - les trois mécanismes expliqués dans comment fonctionne la mémoire d'un compagnon IA, mais avec les commandes à portée de main.
- Images et voix sont des projets à part. La génération d'images demande son propre modèle et en général plus de mémoire graphique ; la voix demande des outils de reconnaissance et de synthèse vocales. Tout est possible, rien n'est automatique.
- Le mobile est malcommode. Vous pouvez ouvrir le front-end depuis votre téléphone en Wi-Fi à la maison. L'utiliser hors de chez vous implique d'exposer votre ordinateur à Internet, ce qui demande de la prudence.
- Un plafond de qualité. Les meilleurs modèles hébergés sont plus grands que tout ce que la plupart des gens peuvent faire tourner chez eux, en particulier pour la cohérence sur le long terme.
La voie intermédiaire, et son piège
Beaucoup de gens font tourner SillyTavern sur leur propre machine mais le connectent à une API cloud payante plutôt qu'à un modèle local. Vous gardez le contrôle du front-end et les fichiers de personnages, vous accédez à des modèles bien plus grands, avec une facturation au message qui peut être économique pour un usage léger.
Ce n'est pourtant pas privé. Chaque message part chez le fournisseur de l'API, soumis à sa journalisation, sa conservation et ses règles de contenu - souvent plus strictes sur le jeu de rôle que celles des applications de compagnon dédiées. C'est un autre compromis, pas une installation locale.
Les bases de la sécurité
- Téléchargez les logiciels uniquement depuis les pages officielles des projets sur GitHub ou le site du projet.
- Téléchargez les modèles chez des éditeurs reconnus sur Hugging Face, et préférez les fichiers GGUF, qui contiennent des données de modèle et non du code.
- Lisez la licence du modèle. Certaines restreignent l'usage commercial ; quelques-unes limitent certains contenus.
- Gardez SillyTavern limité à votre machine ou à votre réseau domestique, sauf si vous avez mis en place un mot de passe et compris ce que vous exposez.
SillyTavern est développé à découvert sur GitHub.
À qui cela s'adresse
Faites tourner un compagnon en local si la confidentialité est votre priorité, si vous possédez déjà du matériel capable, ou si vous aimez autant configurer que utiliser. Restez sur une application hébergée si vous voulez voix, images et longue mémoire prêtes à l'emploi, ou si vous discutez surtout sur téléphone. Notre guide pour choisir une première application couvre cette voie. Beaucoup de gens finissent par avoir les deux : une application hébergée pour le confort, et une installation locale pour les conversations qu'ils préfèrent ne stocker nulle part ailleurs.